-
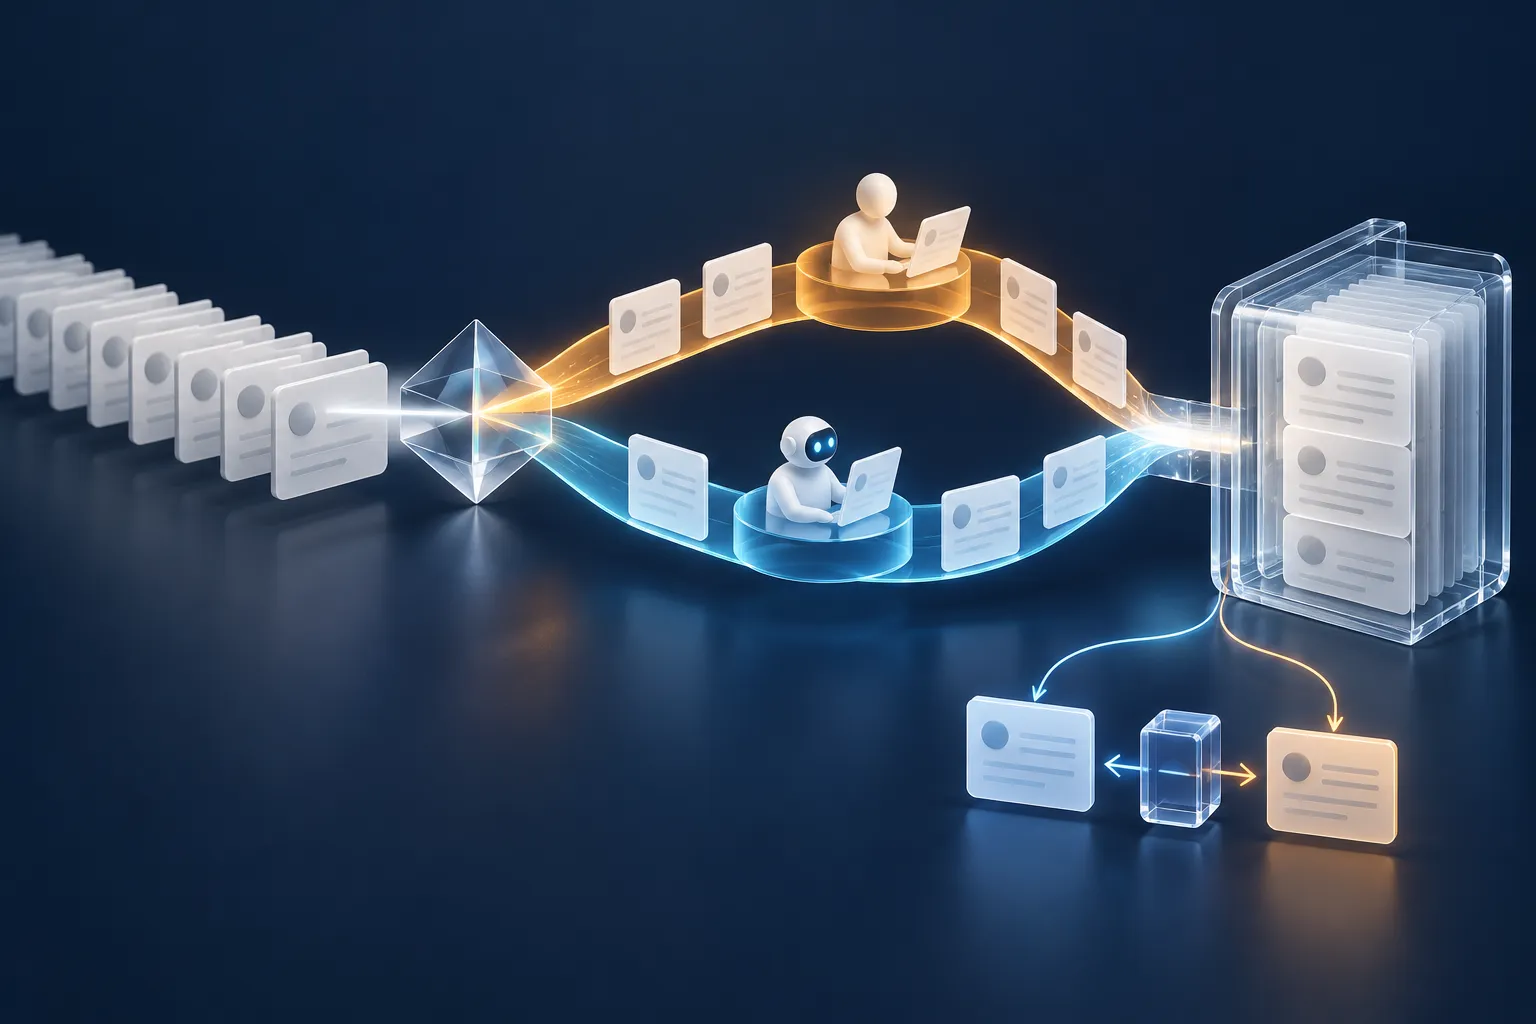 历史上只复核难例,怎样学出复核增益?随机路径探索与折外学习
把人工转交当作有已知概率的路径分配,在两条路径都可行的人群中保留探索,用折外双重稳健分数学习复核增益,并在独立入口队列审计预算规则。
22 分钟 中文 -
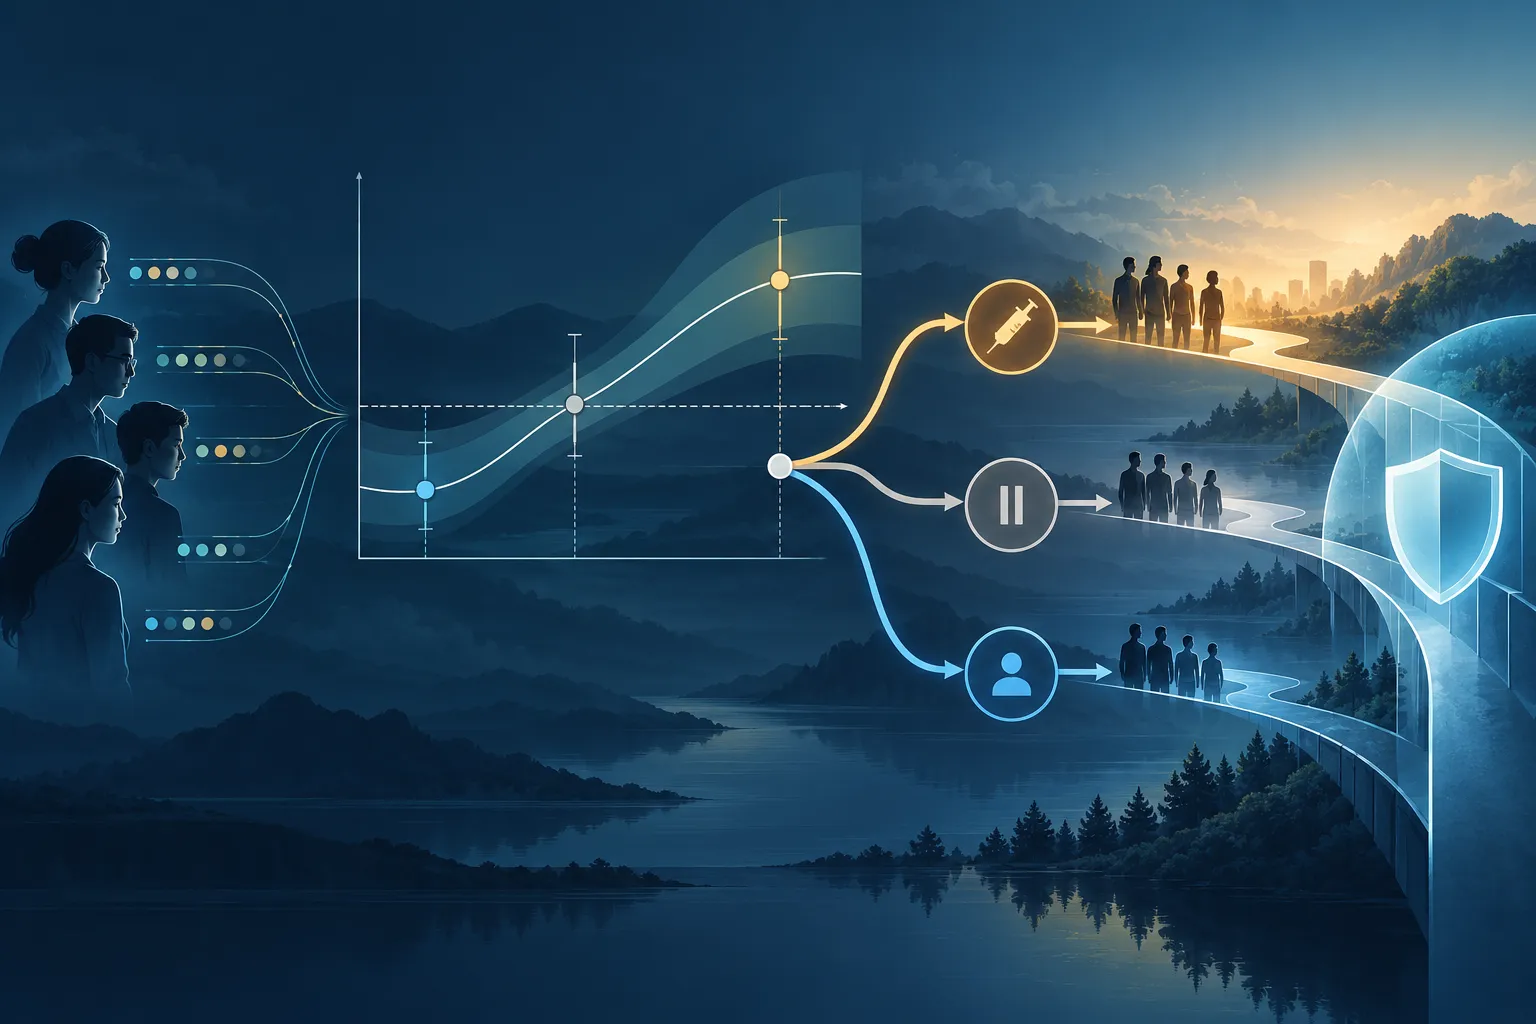 效应估计不确定时,个体化策略何时该干预?用拒绝决策与基线回退守住边界
把条件处理效应的不确定区间与干预成本放进三路决策规则:有把握才干预、明确无益时回到对照、证据不足时拒绝自动决策。
14 分钟 中文 -
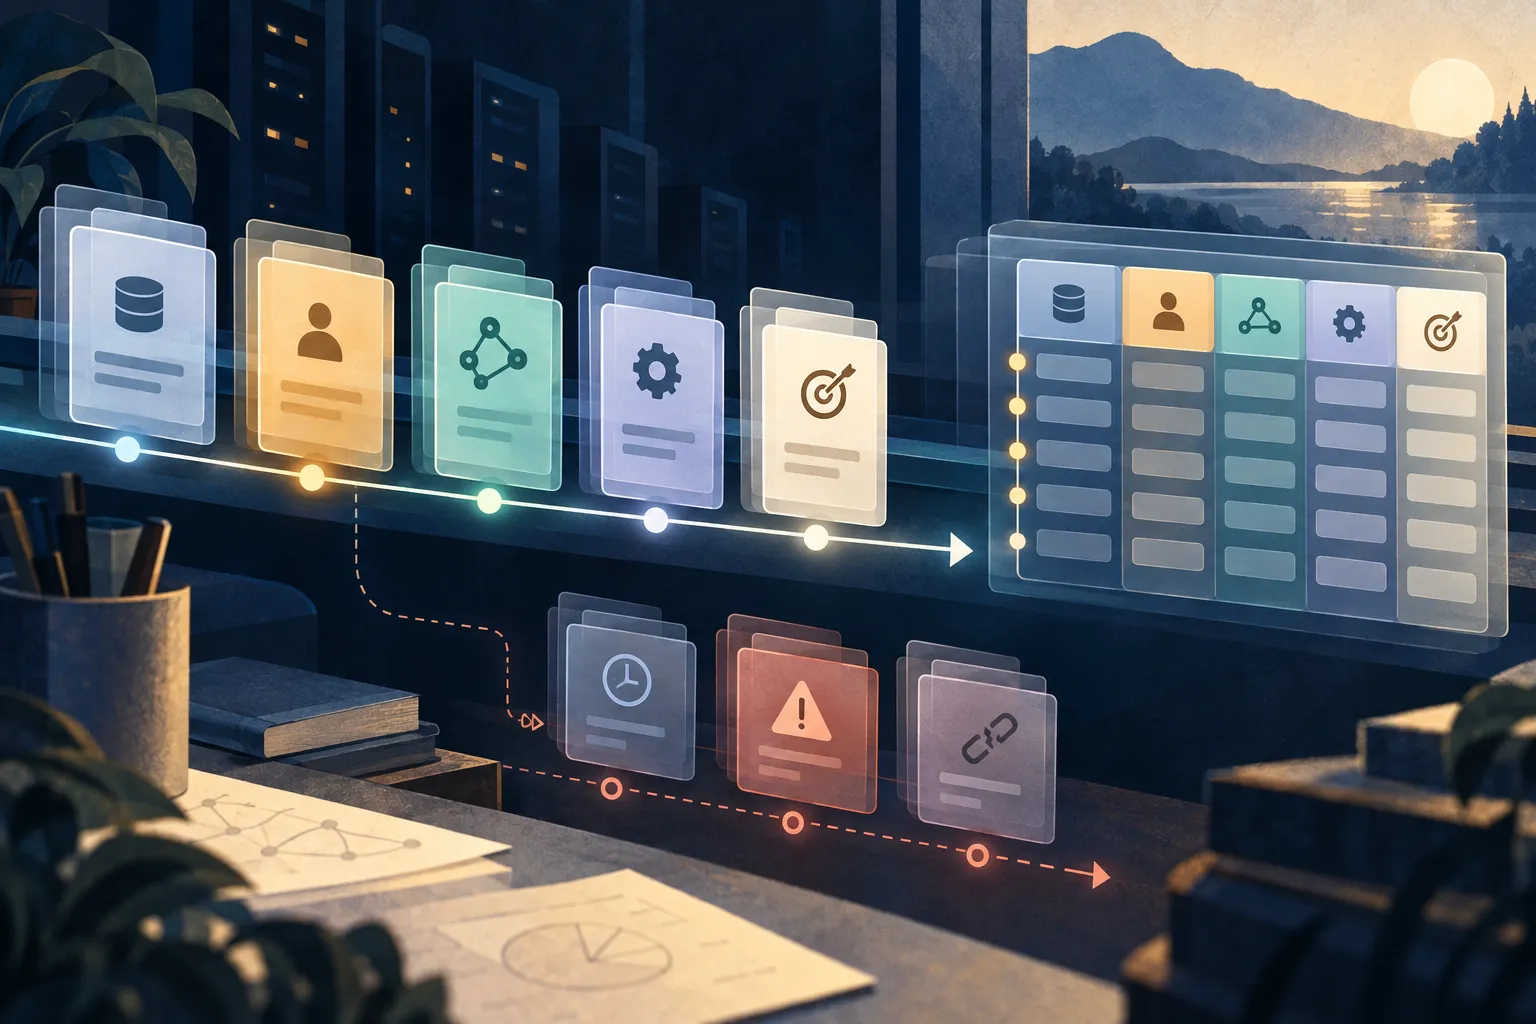 决策账本怎样变成可信的离线回放数据集?按决策键确定性拼表
从不可变决策、执行和结果事件构造一行一个决策的离线策略数据;用事件去重、时点特征、标签水位与连接不变量拦住静默偏差。
22 分钟 中文 -
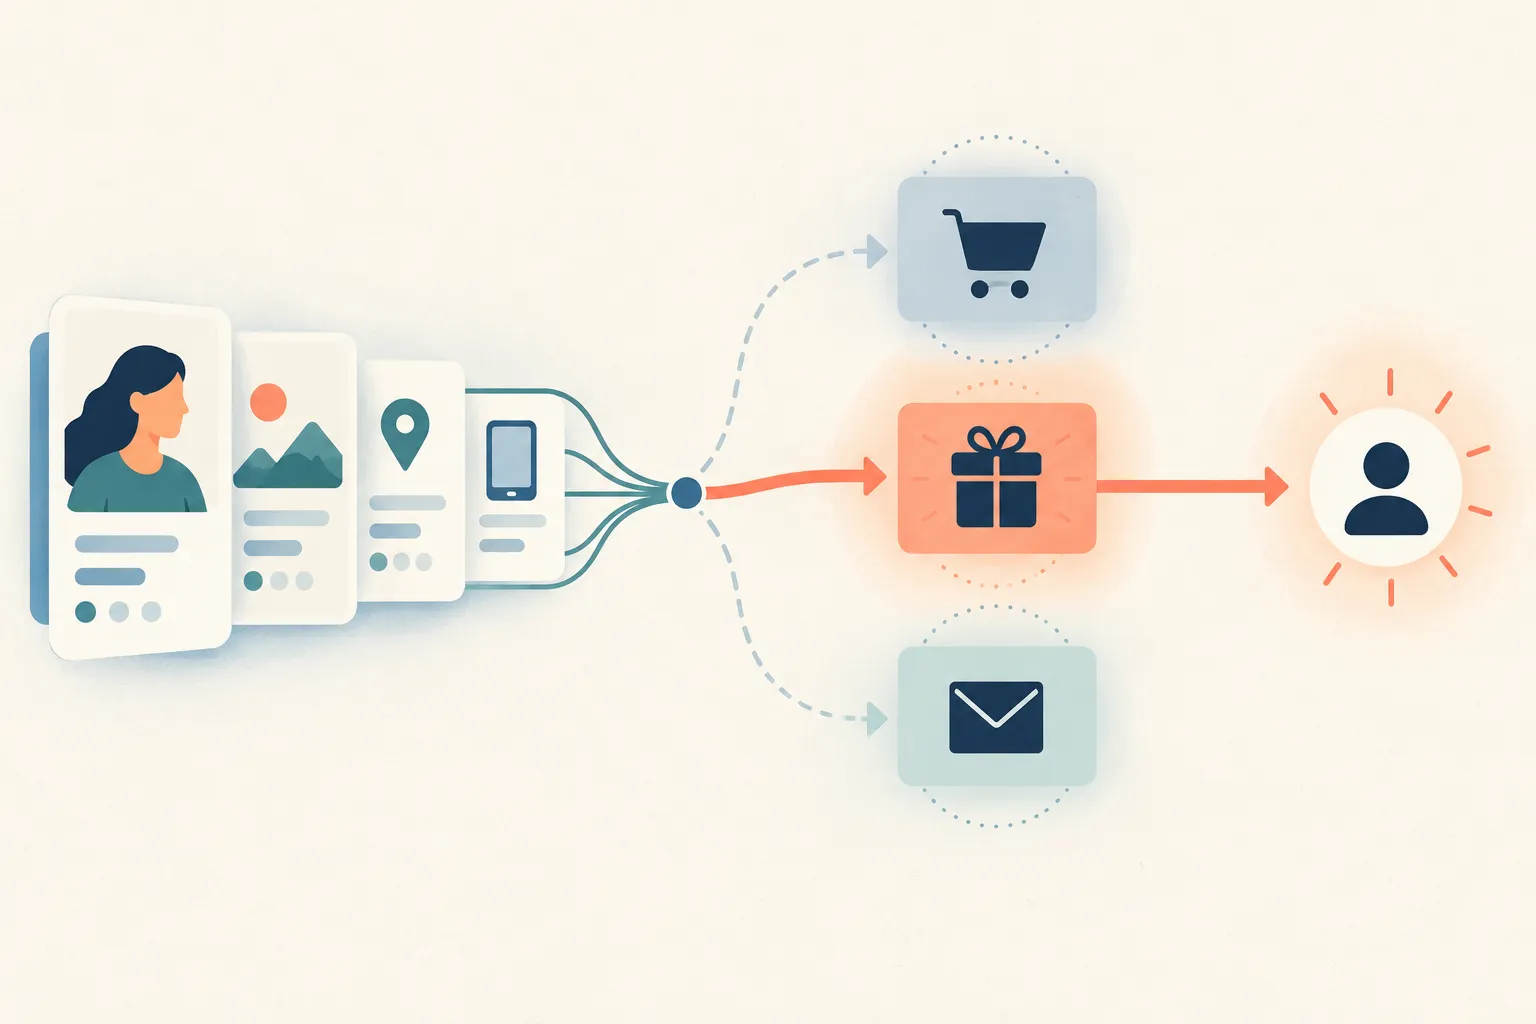 用户为何收到这次干预?用决策级事件账本重放每一次策略动作
把决策时上下文、策略身份、动作概率、执行回执与延迟结果串到同一 decision_id,让策略审计和离线评估有可复核的事实基础。
25 分钟 中文 -
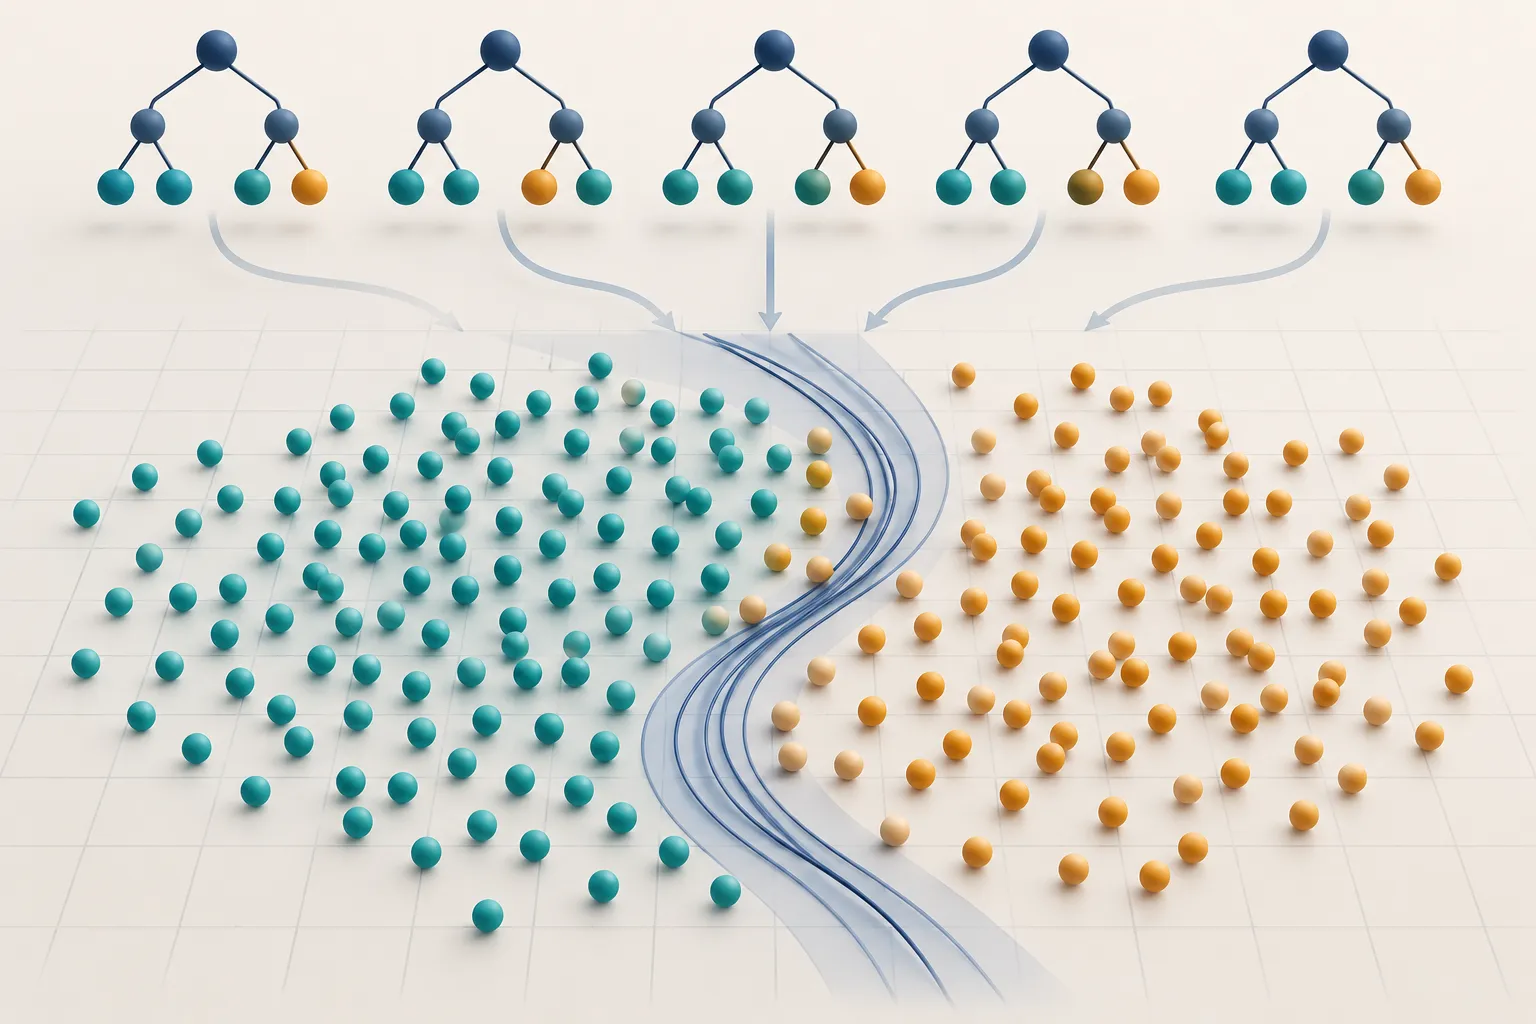 同一策略换一批样本就变样,规则到底稳不稳?Bootstrap 一致性与 Regret 诊断
从策略学习的赢家偏差出发,用分层重抽样比较规则结构、动作一致性与离线 regret,并解释稳定性诊断不能替代独立审计。
18 分钟 中文 -
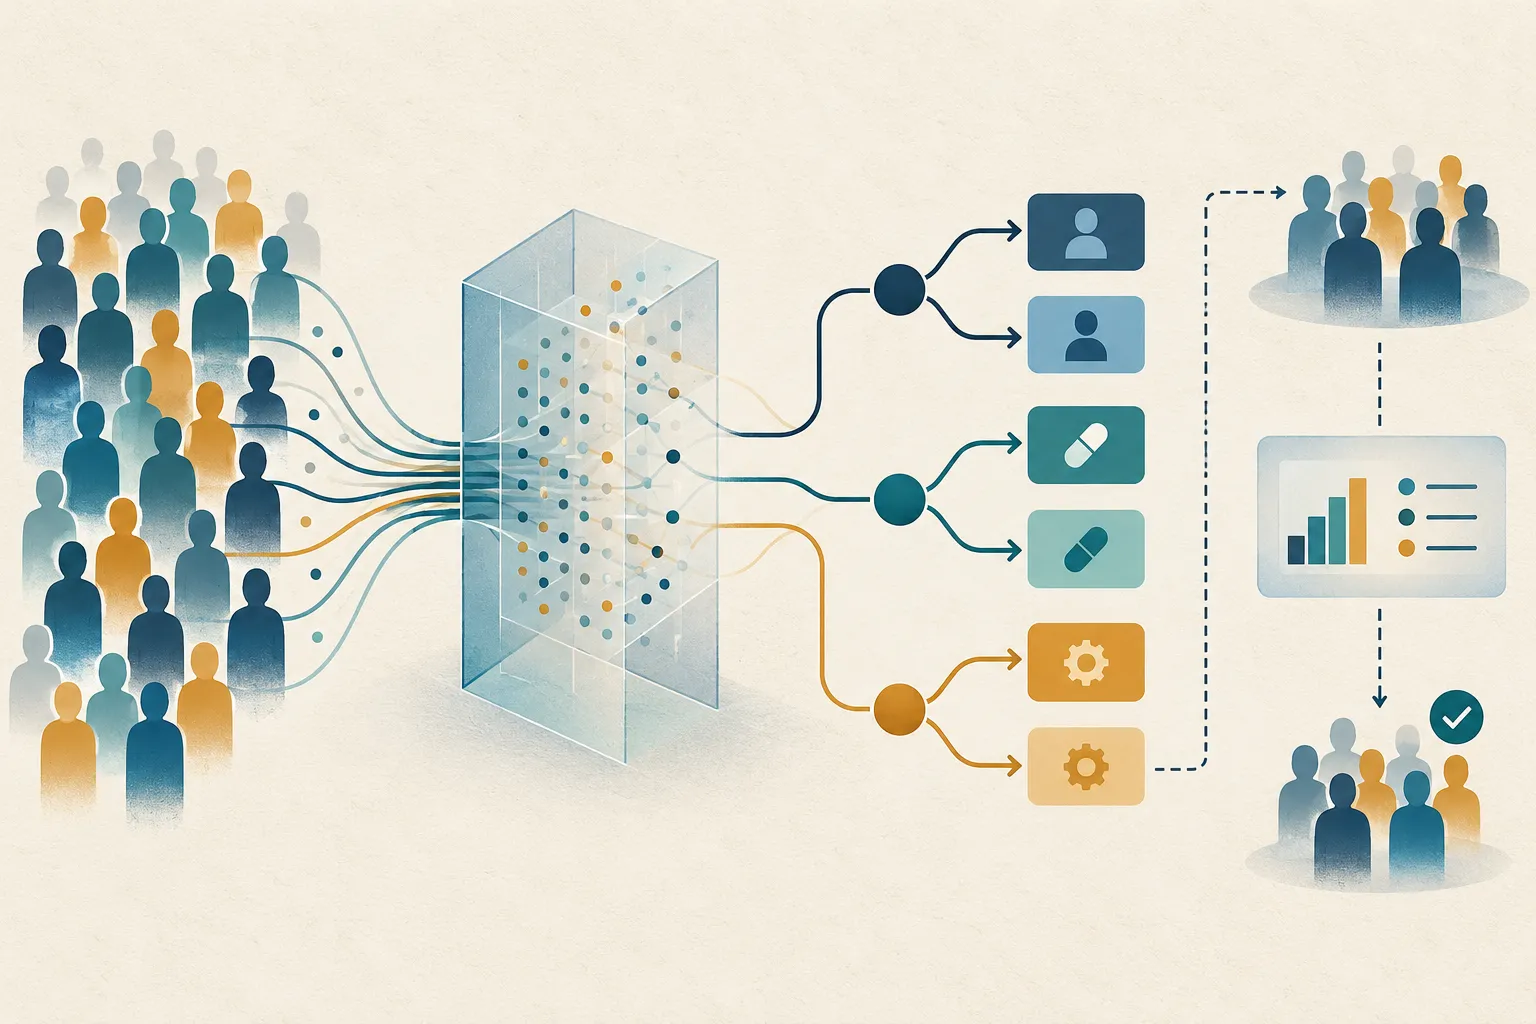 离线评估过关后,怎样从历史日志学出一条可解释的干预规则?双重稳健策略学习
用交叉拟合的双重稳健增益分数训练受限决策规则,并把策略搜索与独立价值审计分开。
17 分钟 中文 -
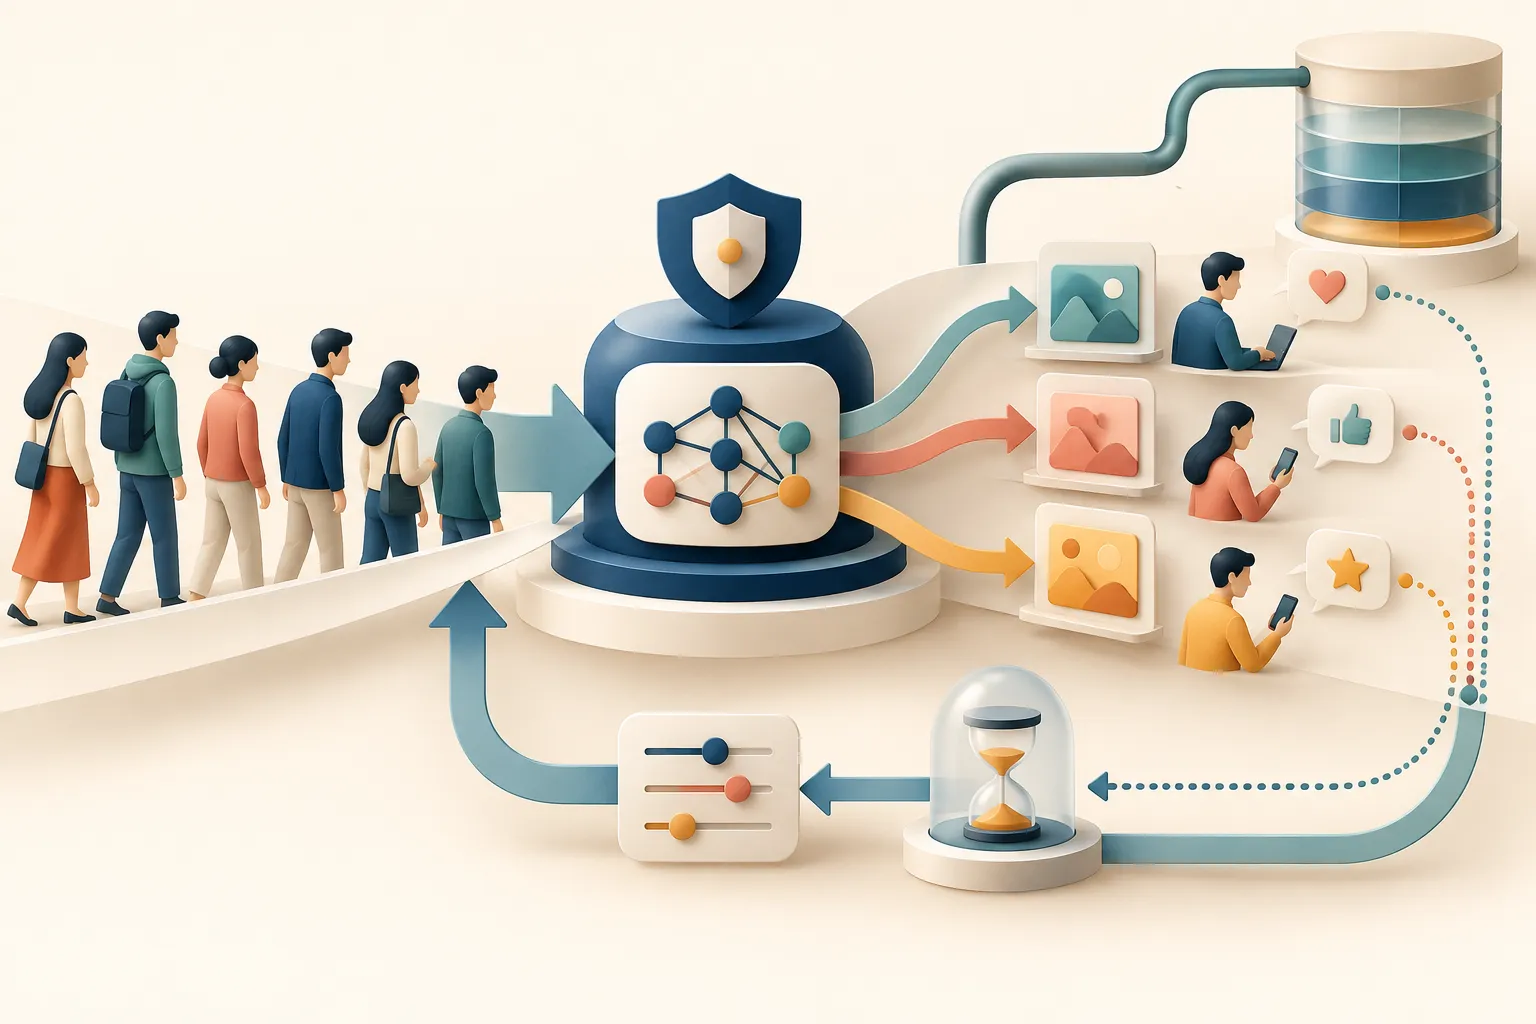 策略上线后人群和资源都在变,怎样监控而不误判?分布、结果与容量三道门
把个体化决策策略的线上监控拆成输入分布、成熟结果和资源容量三类信号,并用冻结基线与滚动快照定位变化来源。
14 分钟 中文 -
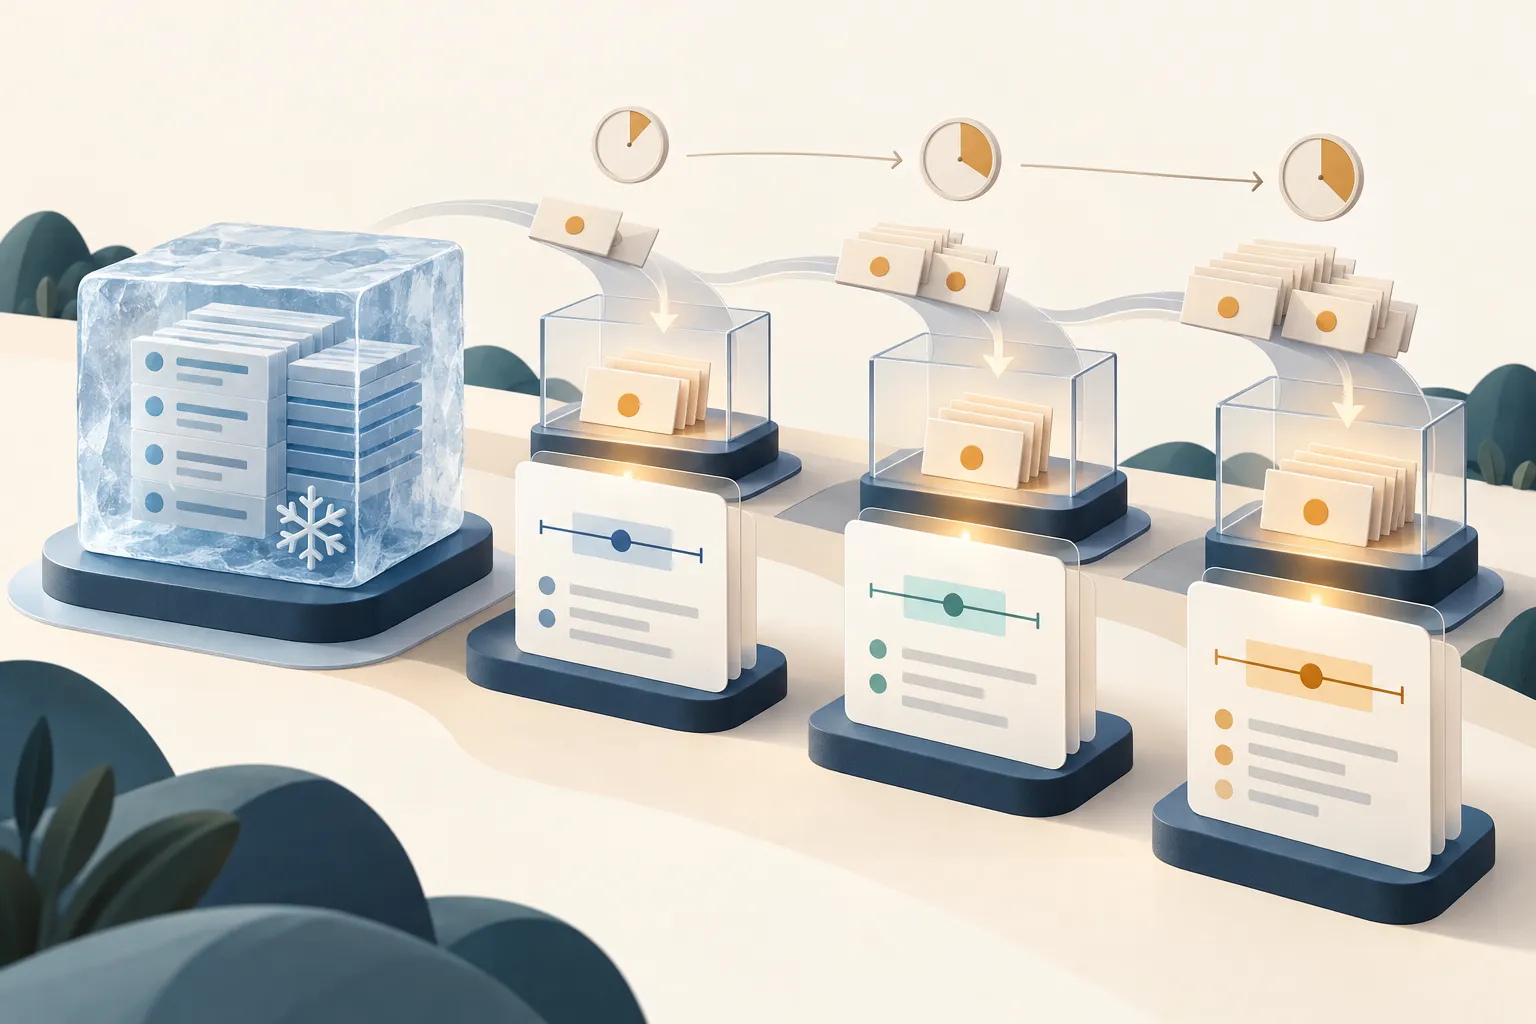 标签逐步到齐时,评估值该怎样更新?延迟标签的成熟窗口与版本快照
将标签成熟、观察窗口和重复查看纳入离线策略评估协议,避免未成熟样本造成虚假的质量变化。
13 分钟 中文
返回